
GUIDE PRATIQUE POUR PME SUISSES
Une méthode accessible pour passer de listes difficiles à maintenir à des données fiables et réutilisables.
| EN BREF Structurer vos données commence par des phrases simples : une ligne représente un événement, une colonne une information et chaque objet possède un identifiant stable. |
La structure est d’abord une question de méthode
Nous vous conseillons de distinguer les règles obligatoires des préférences. Un identifiant client unique est indispensable pour relier les ventes ; l’ordre des colonnes l’est beaucoup moins. Cette hiérarchie évite de transformer le nettoyage en chantier interminable et concentre vos efforts sur ce qui change réellement le résultat.
Pensez aussi aux valeurs manquantes. Une cellule vide signifie-t-elle « inconnu », « non applicable » ou « pas encore saisi » ? Ces situations n’ont pas la même conséquence. Nous les faisons expliciter afin que le futur rapport puisse afficher l’incertitude au lieu de la convertir silencieusement en zéro ou en catégorie par défaut.
Vous n’avez pas besoin d’être développeur pour mettre de l’ordre dans vos données. Vos équipes métier savent déjà ce qu’une commande, un client, une facture ou un mouvement de stock signifie dans la réalité. Notre rôle consiste à transformer cette connaissance en règles simples, visibles et réutilisables, avant que le code ou l’outil ne vienne automatiser quoi que ce soit.
Nous vous proposons de prendre une feuille que vos équipes utilisent tous les jours. Pouvez-vous expliquer en une phrase ce que représente une ligne ? Savez-vous quelles colonnes sont obligatoires, qui corrige une erreur et quel identifiant relie cette feuille aux autres ? Si ces réponses sont claires, vous avez déjà fait une grande partie du travail de structuration.
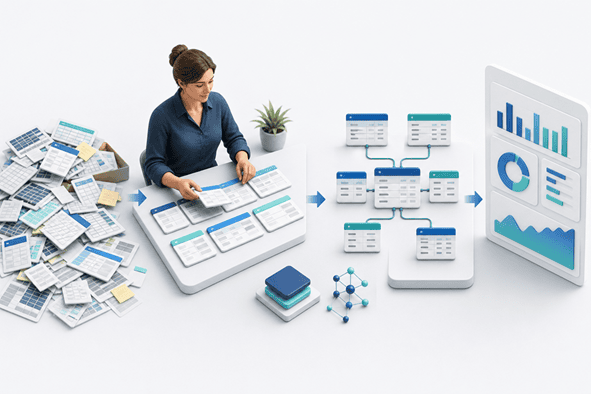
La structure vient d’abord de règles compréhensibles : lignes, colonnes, identifiants et relations.
La démarche s’inscrit dans l’approche pragmatique de Datavizin : partir d’un besoin métier, structurer les données utiles et construire une solution proportionnée.
Identifier l’objet que chaque ligne représente
Cette question paraît presque trop simple, mais elle dénoue beaucoup de problèmes : une ligne représente quoi ? Une commande, une ligne de commande, une facture ou un client ? Si vous mélangez ces niveaux, un total peut être juste dans une vue et faux dans une autre. Nous insistons donc sur cette phrase avant toute transformation.
Une table doit décrire un type d’objet ou d’événement : clients, articles, commandes, factures ou mouvements de stock. Mélanger plusieurs niveaux dans une même feuille rend les calculs ambigus.
Nous vous recommandons de demander : que représente exactement une ligne ? Si la réponse varie, séparez les informations dans plusieurs tables reliées par un identifiant.
Utiliser des colonnes simples et cohérentes
Une cellule doit contenir une information que l’outil peut relire sans interpréter sa couleur ou sa position. Gardez les titres pour le rapport, pas au milieu de la table. Nous vous conseillons aussi d’écrire les règles de saisie dans un endroit visible : ce qui est évident aujourd’hui ne le sera plus forcément pour la prochaine personne.
Chaque colonne doit contenir une seule information : une date, un montant, un code ou une catégorie. Évitez les cellules fusionnées, les sous-totaux au milieu des données et les couleurs utilisées comme information.
Standardisez les formats de date, les unités, les valeurs oui/non et les catégories. Une liste de valeurs autorisées réduit immédiatement les erreurs de saisie.
Concrètement, nous vous proposons de garder ces repères : Un nom de colonne explicite ; Un type de donnée cohérent ; Une règle de saisie connue.
Choisir des identifiants stables
Les libellés sont faits pour être lus ; les identifiants sont faits pour relier. Un client peut changer de raison sociale et un produit de nom commercial, sans devenir un nouvel objet. Lorsque nous constatons que les jointures reposent uniquement sur des noms, nous créons ou rétablissons une clé stable avant d’aller plus loin.
Le nom d’un client ou d’un produit peut changer. Un identifiant unique permet de relier les tables sans dépendre de libellés variables.
Si aucun identifiant n’existe, créez-en un et documentez la règle. N’utilisez pas le numéro de ligne, qui change lorsque les données sont triées ou déplacées.
Séparer la donnée brute, la donnée nettoyée et le reporting
Cette séparation vous donne un droit au retour. Si un chiffre surprend, vous pouvez comparer la source reçue, la règle appliquée et le résultat affiché. Sans ces étapes distinctes, la correction se fait directement dans le rapport et personne ne sait ensuite reproduire ce qui a changé.
Nous vous conseillons de conserver une copie de la source, appliquez les transformations dans une étape distincte, puis alimentez le rapport. Cette séparation améliore la traçabilité et permet de reproduire le résultat.
Lorsque plusieurs sources doivent être croisées ou historisées, un data mart ou une base de données devient plus fiable qu’un empilement de feuilles Excel.
Documenter avant d’automatiser
Nous ne cherchons pas une documentation encyclopédique. Une page qui indique la définition, la source, le responsable et le contrôle principal de chaque champ critique suffit souvent pour démarrer. Ce petit effort protège votre autonomie et accélère toutes les discussions futures.
Un petit dictionnaire de données suffit pour commencer : nom, définition, source, format, responsable et règle de qualité. Cette documentation évite que les connaissances restent dans la tête d’une seule personne.
La méthode ECSTAA de Datavizin aide à explorer les systèmes, comprendre la production des données, structurer les fondations puis analyser et agir.
Comment nous vous aidons à passer à l’étape suivante
Vous pouvez commencer sans outil supplémentaire. Choisissez une table, écrivez ce que représente une ligne, entourez la clé et notez les trois colonnes dont l’erreur fausserait une décision. Puis identifiez la personne qui peut valider chacune de ces règles. Ce petit exercice nous donne déjà une base solide pour préparer une automatisation ou un modèle plus robuste.
Le bon prochain pas dépend moins de la technologie que de la clarté du périmètre, de la disponibilité des données et de l’engagement des utilisateurs. Un atelier court permet souvent de vérifier ces trois conditions.
| PROCHAINE ÉTAPE Consultez le modèle ECSTAA et le Data Strategy Toolkit pour structurer vos données de manière progressive. |